الذكاء الاصطناعي للألعاب
برامج تتقن الألعاب، المعيار الاستعراضي للذكاء الاصطناعي، من برنامج الداما ذاتي التعلّم لصامويل إلى هزيمة AlphaGo لبطل لعبة Go لي سي-دول.
- 1952
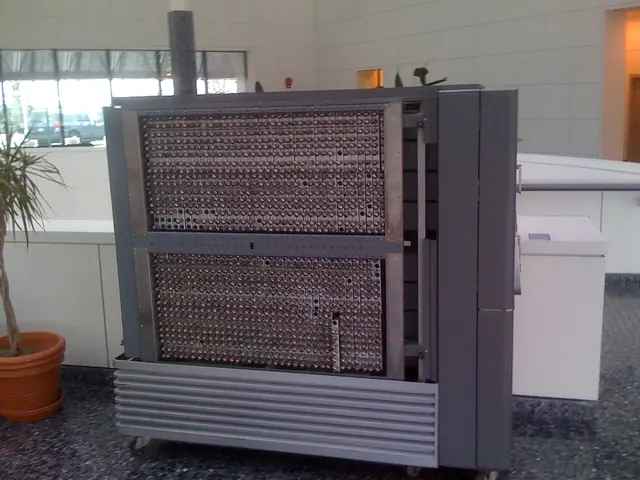
النسخة الأولى
آرثر صامويل (IBM)
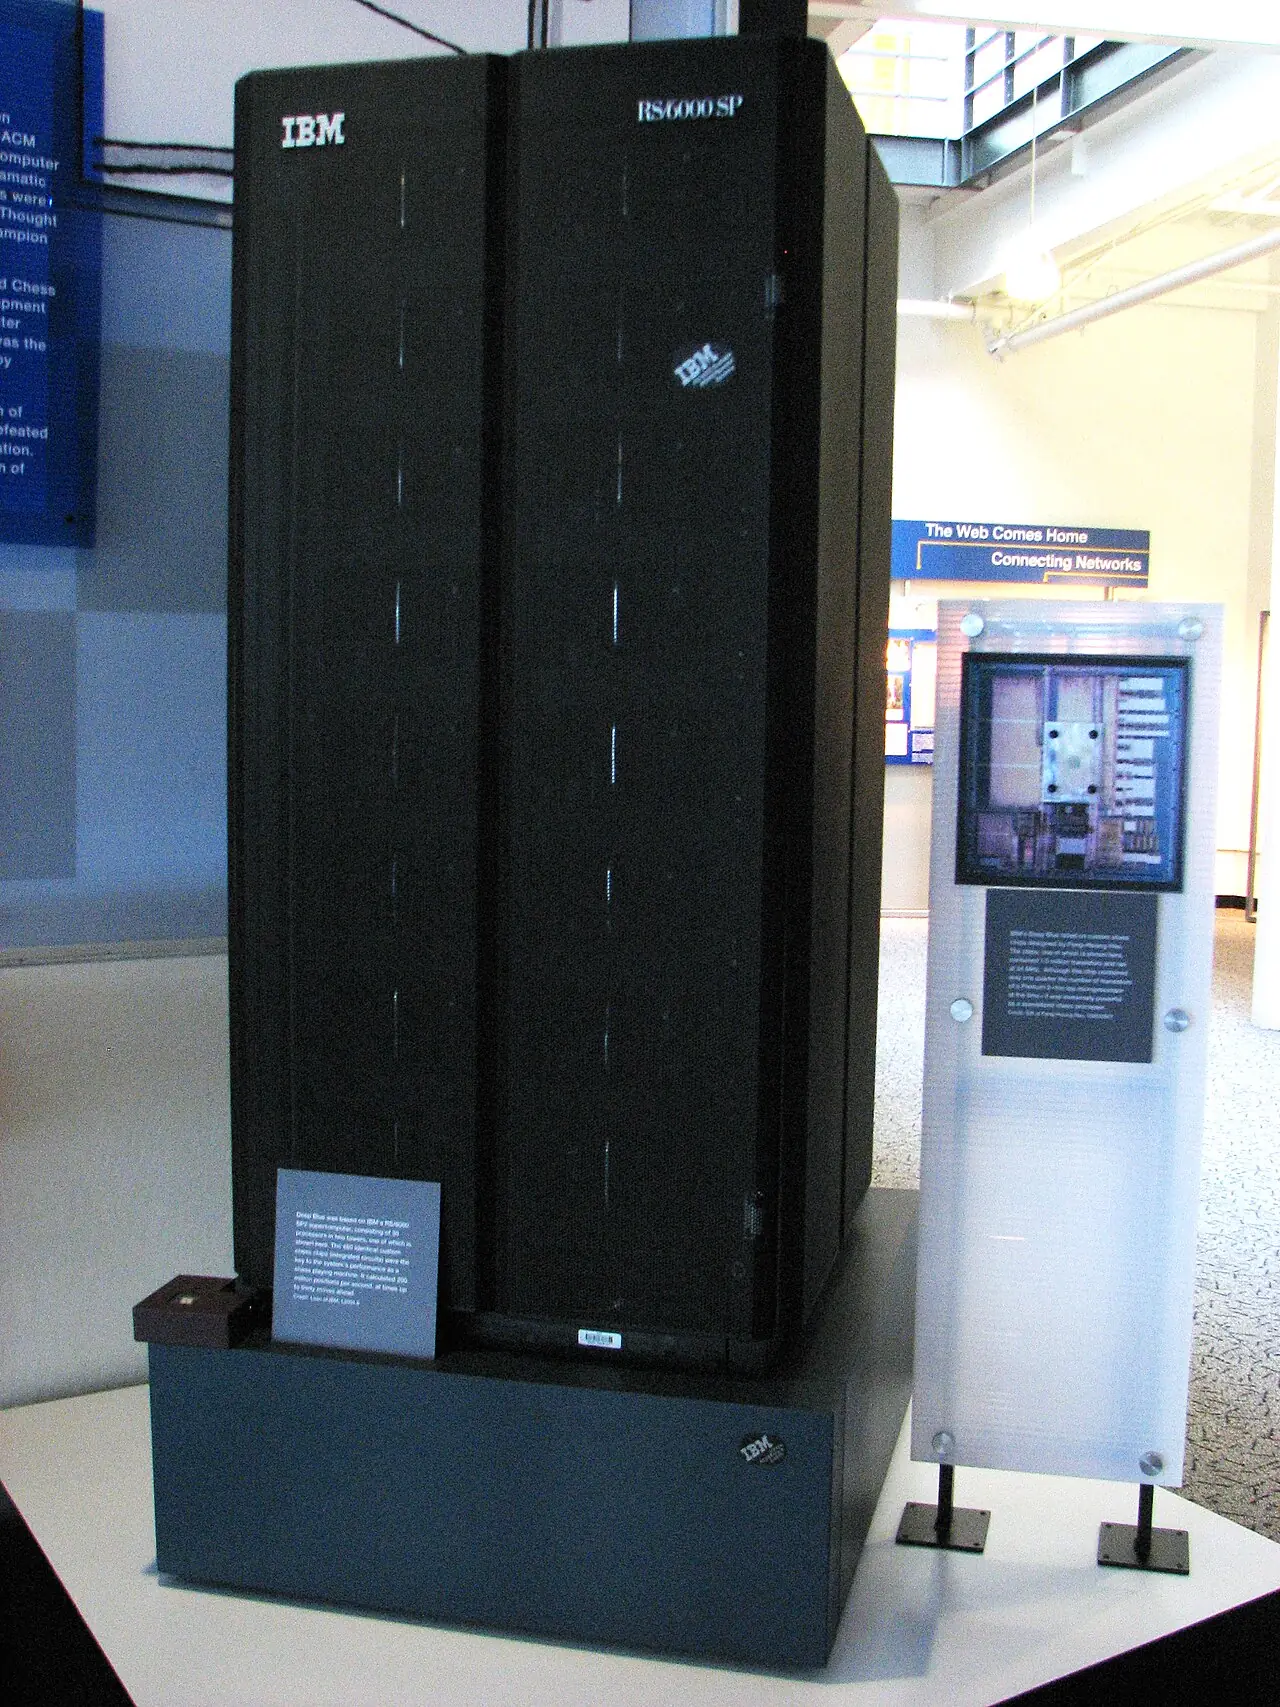
الصورة: Dan · CC BY-SA 2.0 · Wikimedia Commons - 1997
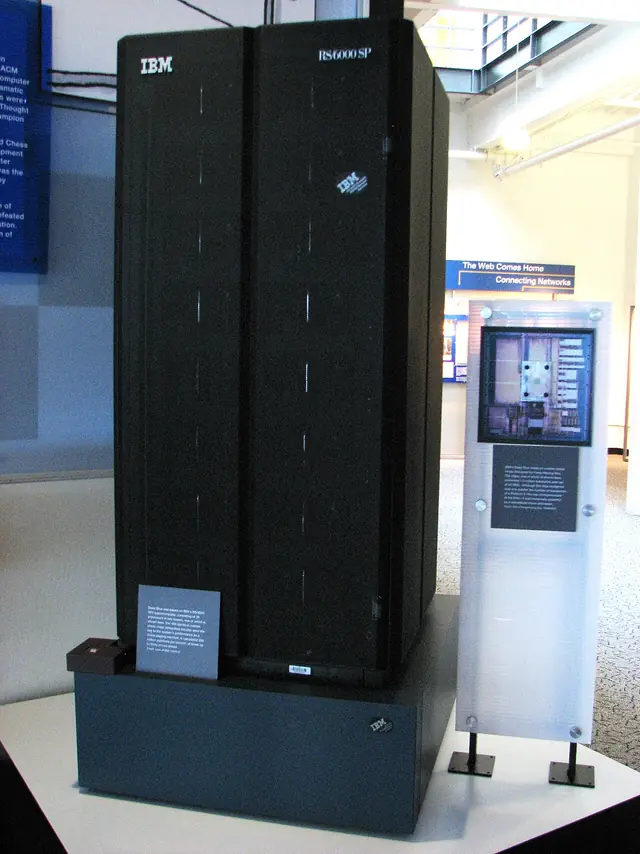
حاسوب Deep Blue من IBM
يهزم بطل العالم في الشطرنج غاري كاسباروف في مباراة من ستة أشواط.
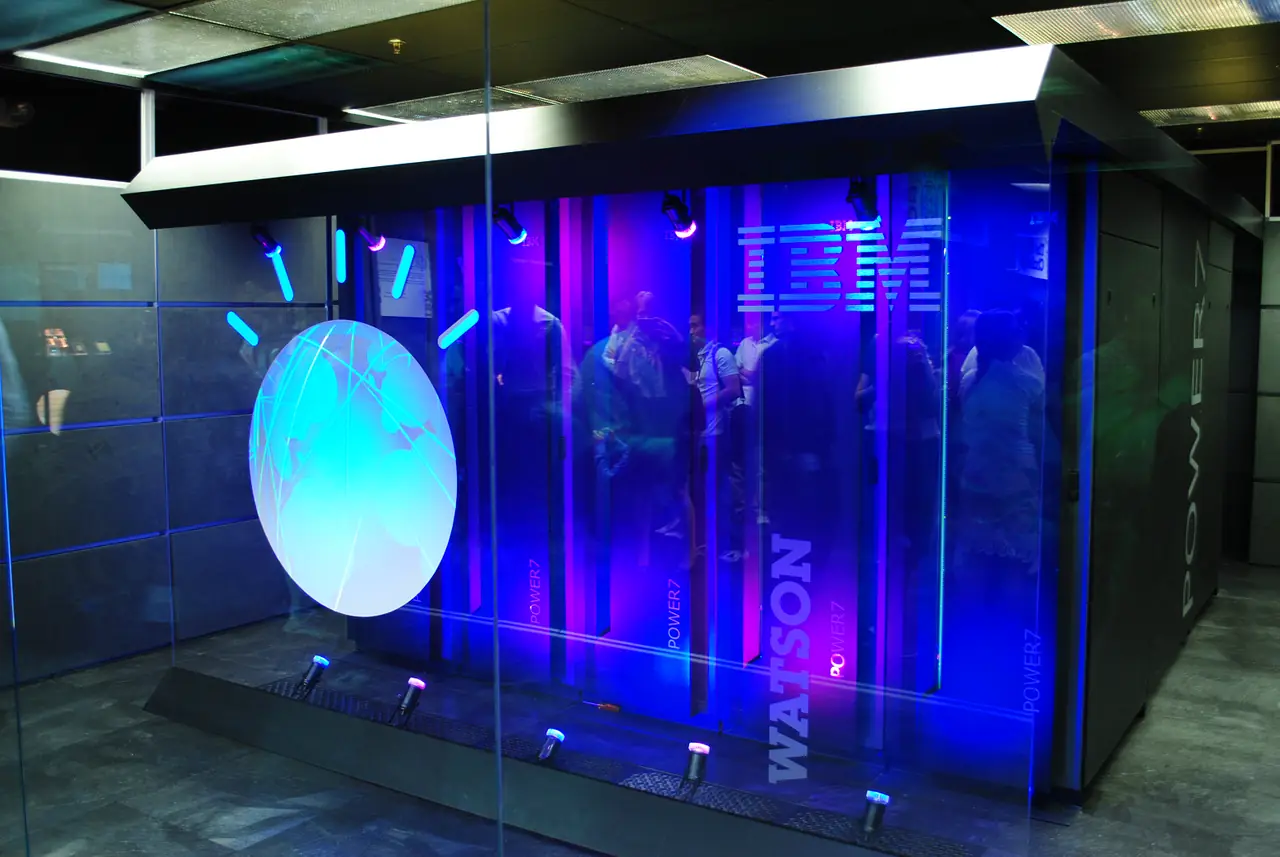
الصورة: Christina Xu · CC BY 2.0 · Wikimedia Commons - 2011
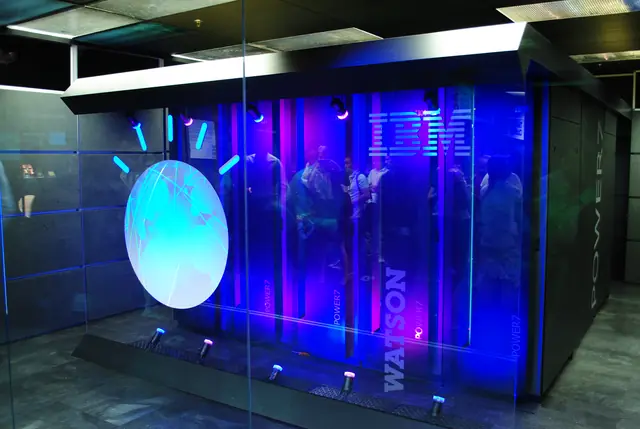
نظام Watson من IBM
يفوز في برنامج Jeopardy! على كين جينينغز وبراد روتر بالإجابة عن أسئلة مفتوحة المجال.
الصورة: Clockready · CC BY-SA 3.0 · Wikimedia Commons - 2016
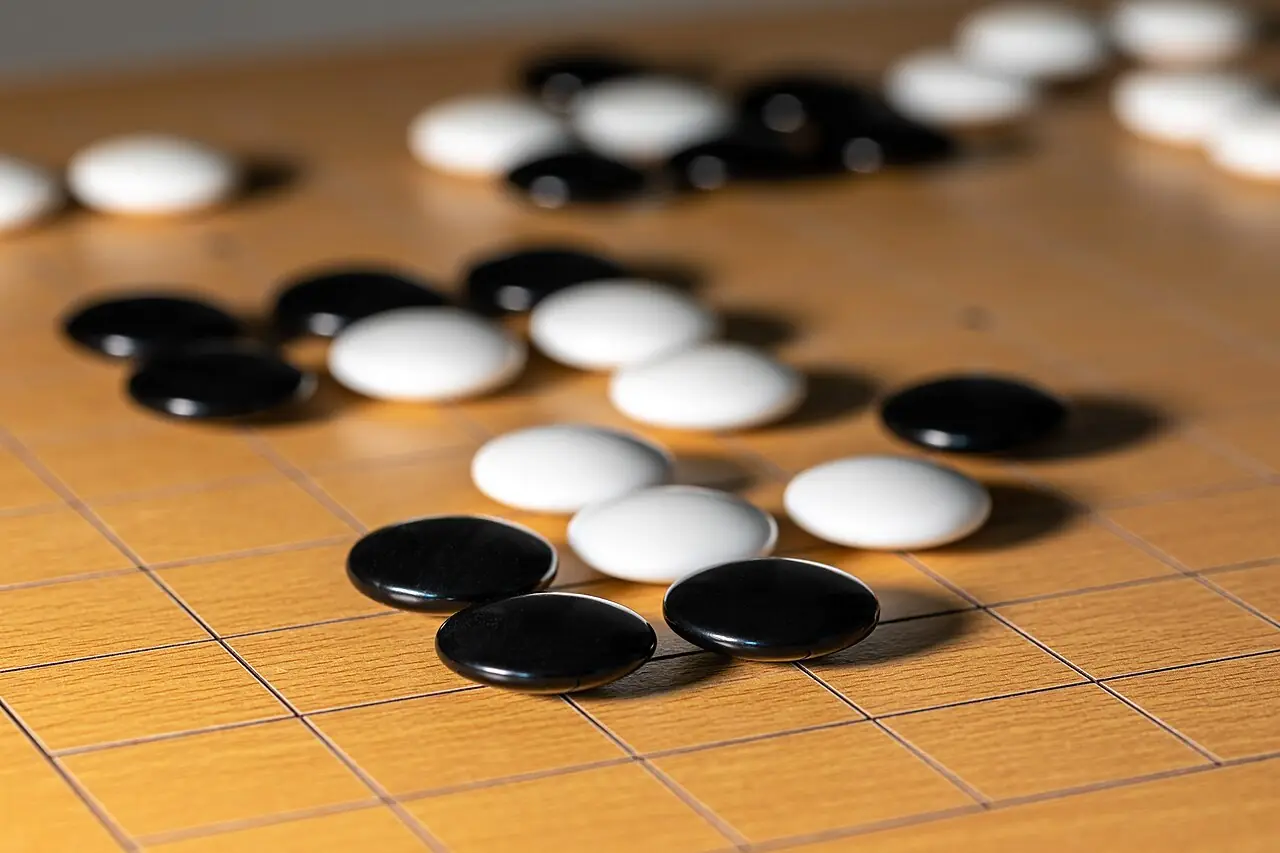
برنامج AlphaGo (DeepMind)
شبكات عميقة مع البحث الشجري تهزم لي سي-دول 4–1 في لعبة Go.
الصورة: Google DeepMind · Public domain · Wikimedia Commons - 2017
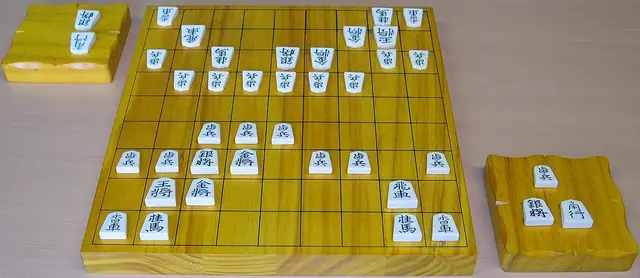
برنامج AlphaZero
يتعلّم الشطرنج والشوغي وGo باللعب الذاتي وحده، دون مباريات بشرية.
الصورة: Oliver Orschiedt · CC BY-SA 3.0 · Wikimedia Commons - 2017
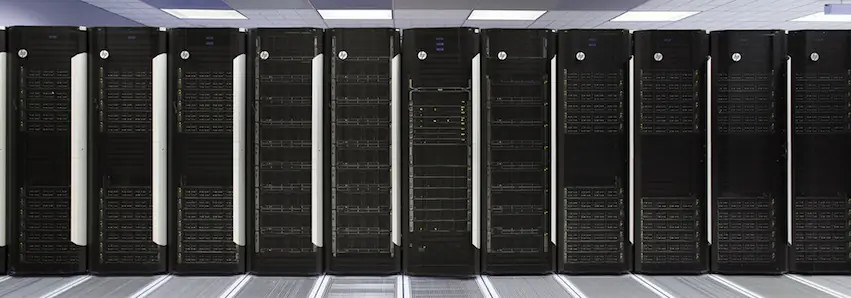
Libratus (جامعة كارنيغي ميلون)
يهزم أربعة من كبار المحترفين في بوكر تكساس هولدم الثنائي بلا حدود عبر 120,000 يد، متقنًا الأوراق المخفية والخداع.
الصورة: Pittsburgh Supercomputing Center · Unclear; (c) PSC, no licence stated · PSC website (psc.edu), Wayback capture 2017 - 2019
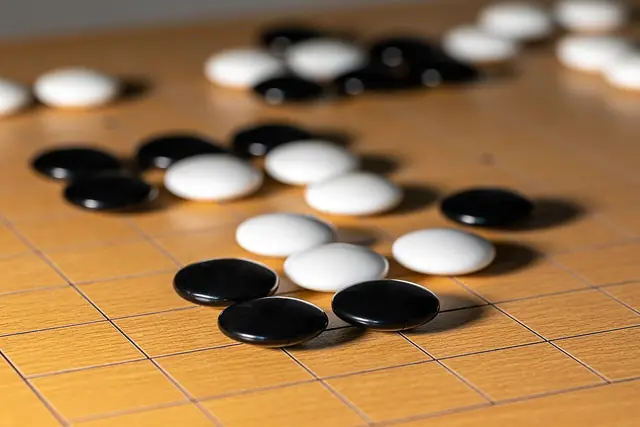
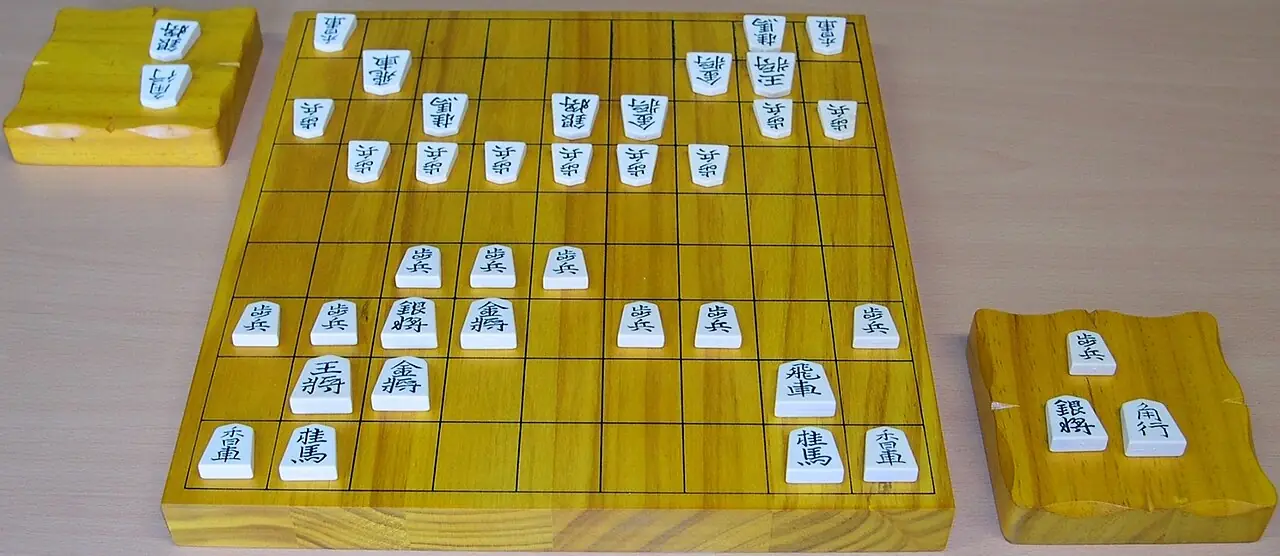
برنامج MuZero
يتقن الألعاب دون أن تُشرح له قواعدها، إذ يتعلّم نموذجه الخاص لها.
الصورة: Dietmar Rabich · CC BY-SA 4.0 · Wikimedia Commons
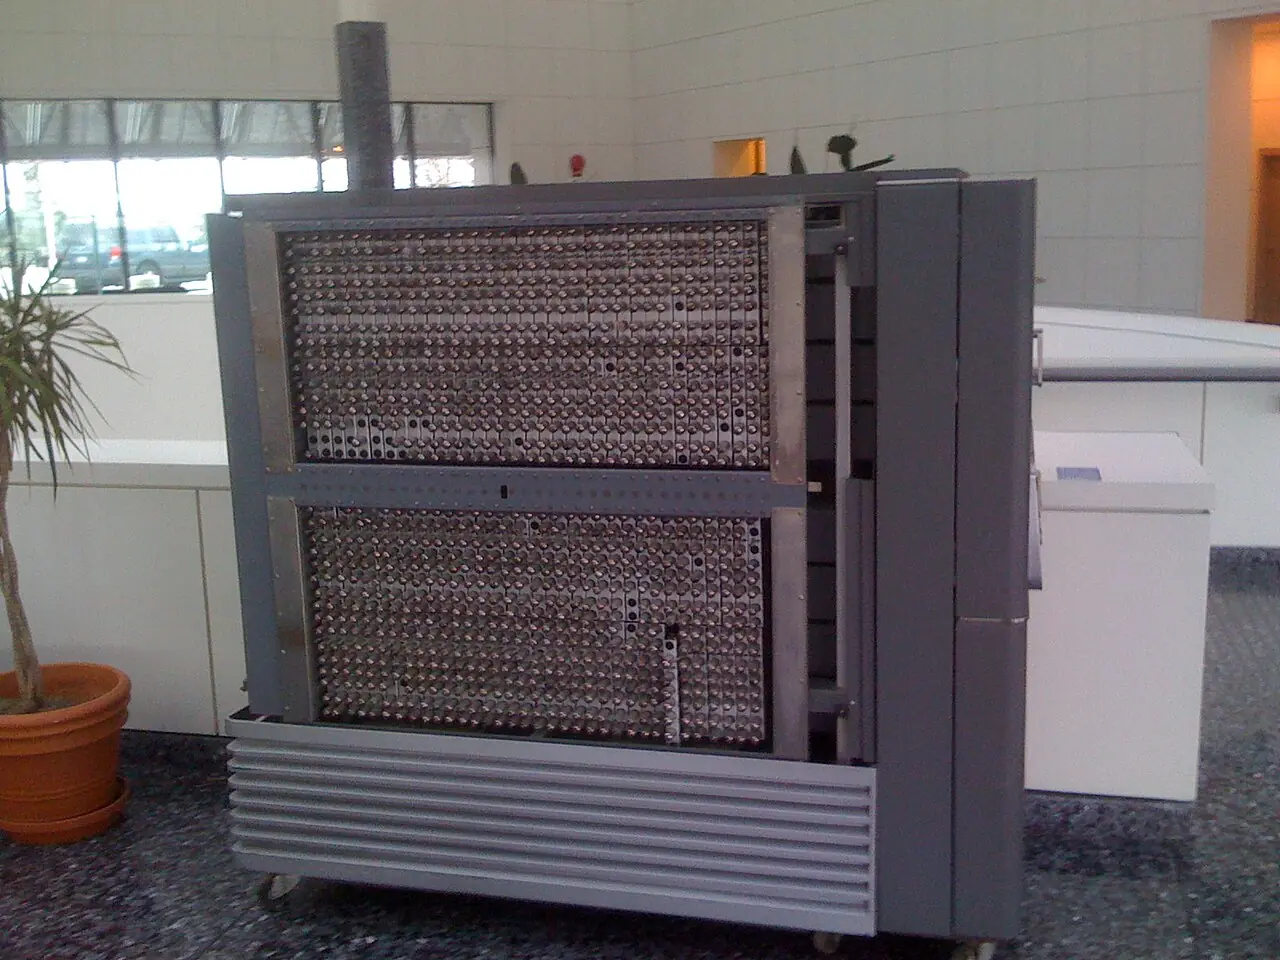


موضع خلاف: لعب الإنسان الآلي El Ajedrecista لتوريس كيفيدو عام 1912 نهايات الشطرنج؛ وبرنامج الداما لكريستوفر ستراتشي عام 1951 أسبق من برنامج صامويل.