التعلّم العميق
تدريب شبكات عصبية متعددة الطبقات على بيانات ضخمة ومعالجات GPU؛ ومنذ 2012 تفوّق على الأساليب الأخرى في الرؤية والكلام واللغة.
- 2006
النسخة الأولى
جيفري هينتون، يان ليكون، يوشوا بنجيو وآخرون
الصورة: University of Toronto · Unclear; no licence stated (university logo, trademark) · Wayback Machine capture of utoronto.ca, 1 Jul 2006 (site header background image) - 2012
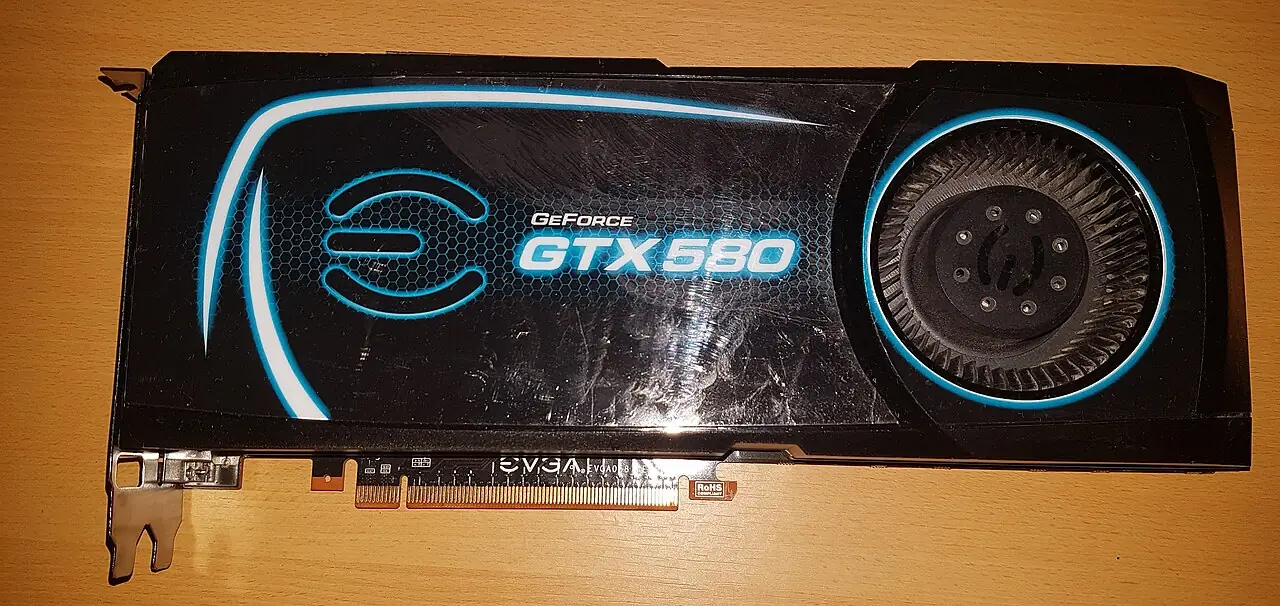
شبكة AlexNet
شبكة CNN مدرّبة على GPU تفوز بمسابقة ImageNet بخطأ في أفضل 5 توقعات قدره 15.3% مقابل 26.2%، فتشعل الطفرة.
الصورة: TheStriker · CC BY-SA 4.0 · Wikimedia Commons - 2015
شبكة ResNet (أبحاث Microsoft)
الوصلات المتبقية تتيح شبكات من 152 طبقة؛ وخطأ 3.57% على ImageNet.
الصورة: Microsoft Research · Unclear; no licence stated (© Microsoft) · Wayback Machine capture of research.microsoft.c… - 2017
معمارية Transformer
الانتباه يحل محل الالتفاف والتكرار، فتصبح المعمارية السائدة في التعلّم العميق للغة والصور وغيرهما.
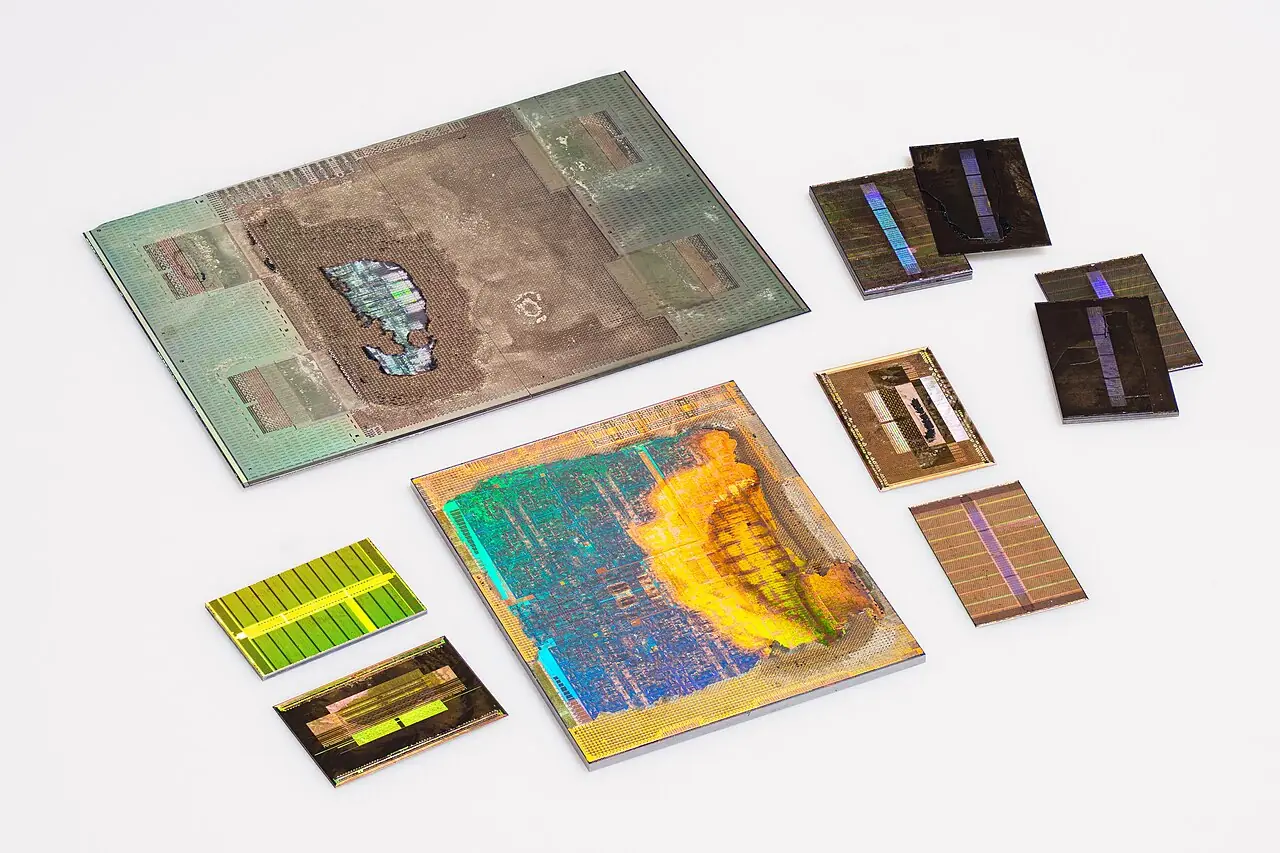
الصورة: FritzchensFritz · CC0 · Wikimedia Commons


موضع خلاف: درّب إيفاخنينكو شبكات عميقة عام 1965؛ ويعترض شميدهوبر على نسب ابتكار التعلّم العميق إلى ثلاثي جائزة تورينغ.