مسرّعات الذكاء الاصطناعي (Google TPU وخلفاؤها)
رقاقات مخصصة لرياضيات الشبكات العصبية؛ كانت أول TPU من Google أسرع 15–30 مرة من المعالجات ووحدات GPU المعاصرة، فأطلقت منافسين كثيرين.
- 2016
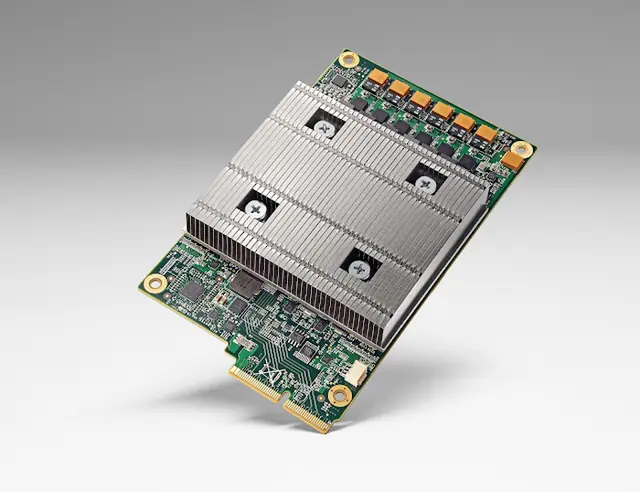
النسخة الأولى
شركة Google
الصورة: Google · Unclear; Google's image page provides n… · Google Cloud Blog - 2017
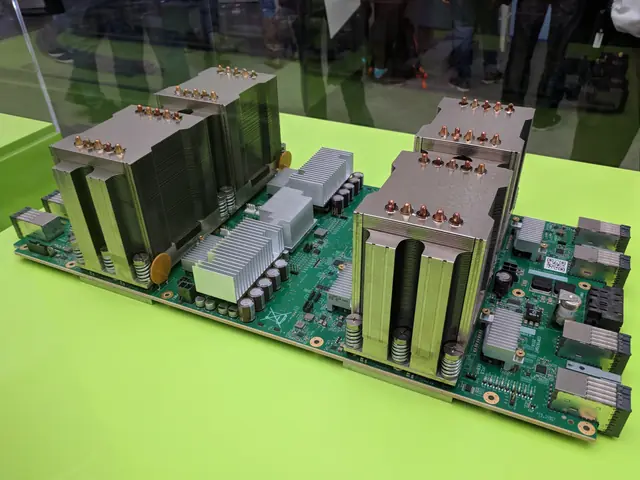
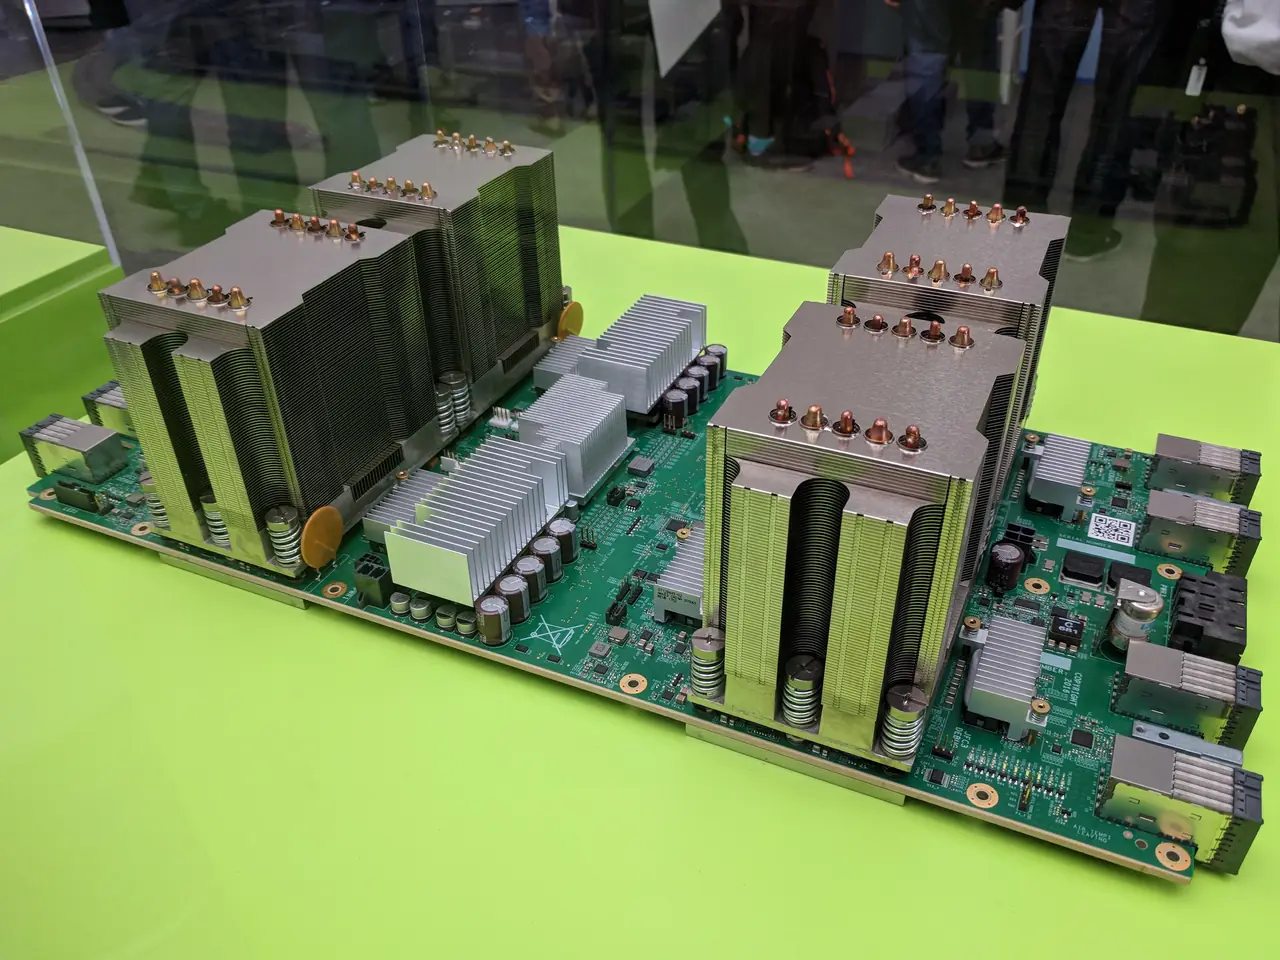
الجيل TPU v2
يضيف التدريب بالفاصلة العائمة وذاكرة HBM وربطًا شبكيًا بين الرقاقات لبناء العناقيد.
الصورة: Rob Pegoraro · CC BY-NC-SA 2.0 · Flickr (via Openverse) - 2021
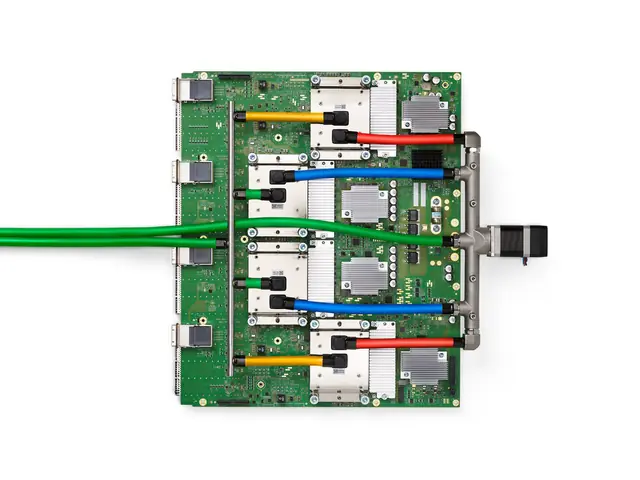
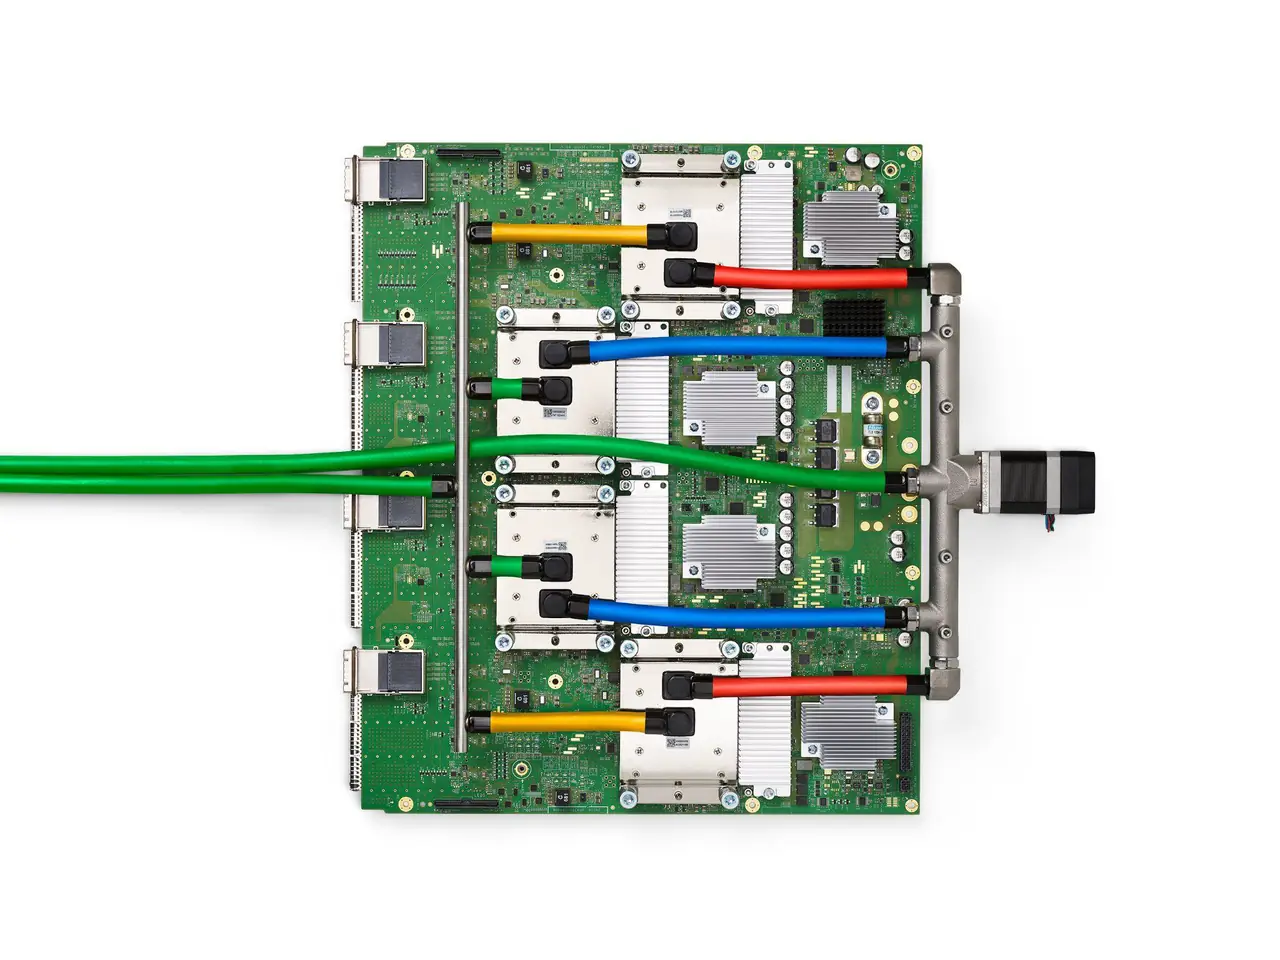
الجيل TPU v4
شبكة عناقيد ثلاثية الأبعاد بتبديل دوائر ضوئي؛ وإضافة أنوية SparseCores.
الصورة: Norman P. Jouppi, George Kurian, Sheng Li, Peter Ma, Rahul Nagarajan, Lifeng Na… · CC BY 4.0 · Wikimedia Commons
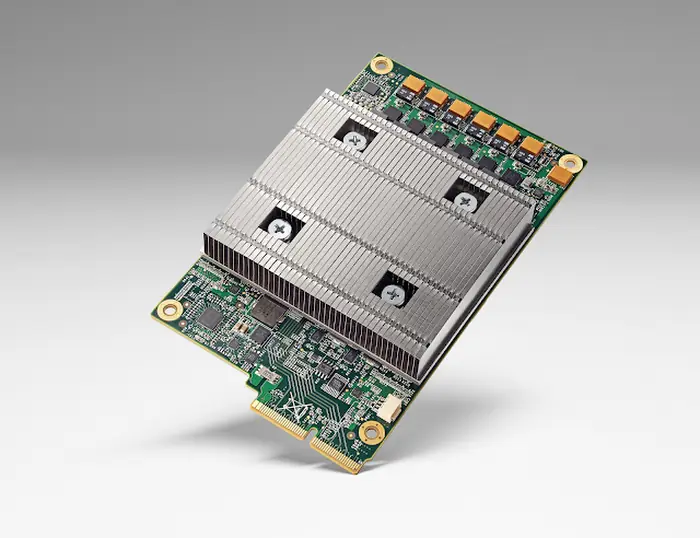

موضع خلاف: تقول Google إن العمل على ASIC صار ملحًّا عام 2013؛ وعملت وحدات TPU في مراكز بياناتها قبل إعلان 2016 (ويُؤرَّخ غالبًا بعام 2015).