معمارية Transformer
استبدلت ورقة «الانتباه هو كل ما تحتاجه» التكرار بالانتباه الذاتي المتوازي، وهي المعمارية وراء كل نماذج اللغة والصور والفيديو الحديثة تقريبًا.
- 2017
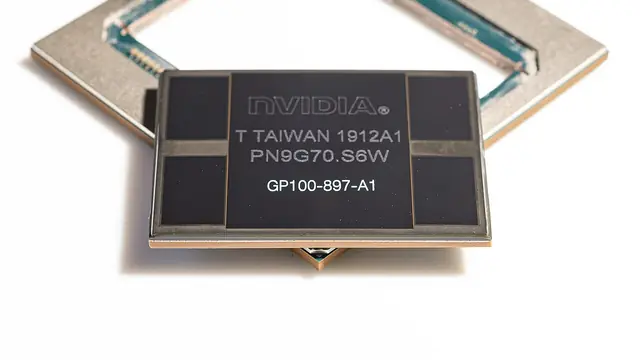
النسخة الأولى
آشيش فاسواني، نعوم شازير، نيكي بارمار، ياكوب أوسكوريت، ليون جونز، إيدن غوميز، لوكاش كايزر، إيليا بولوسوخين (Google)
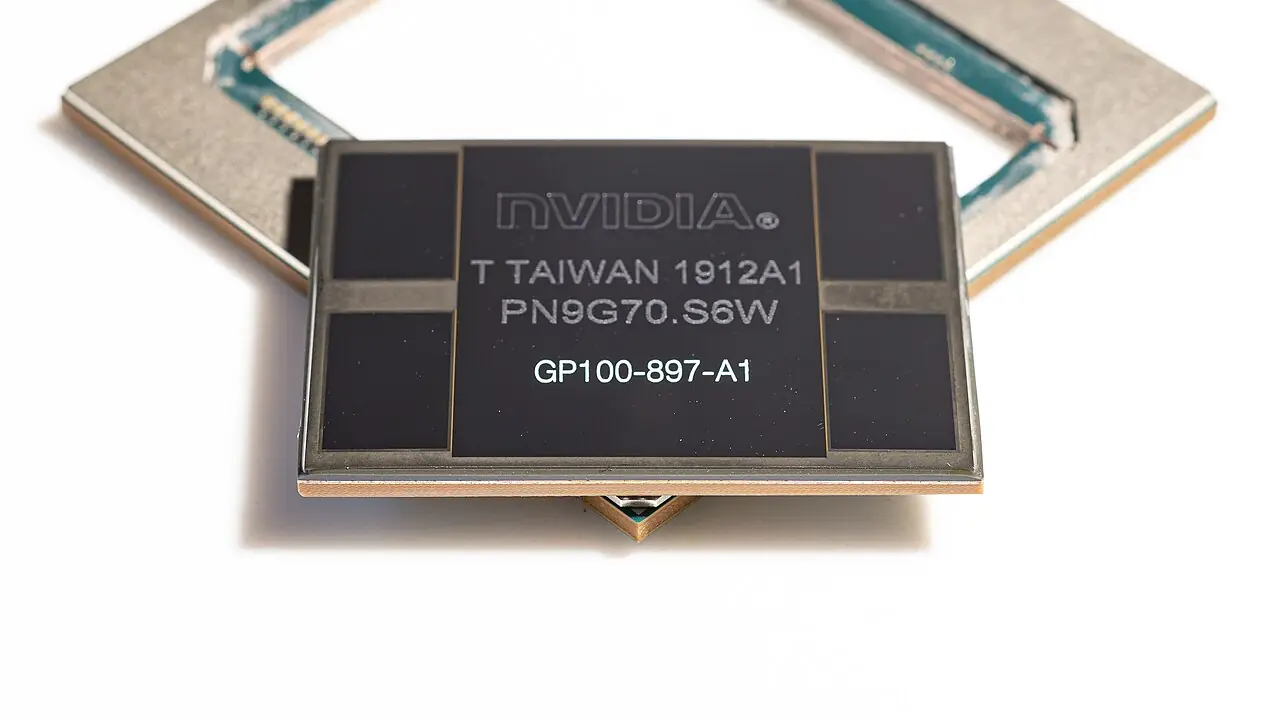
الصورة: FritzchensFritz · CC0 · Wikimedia Commons - 2018
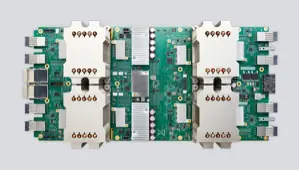
نموذج BERT (Google)
التدريب المسبق ثنائي الاتجاه يغيّر معايير معالجة اللغة الطبيعية وترتيب نتائج البحث.
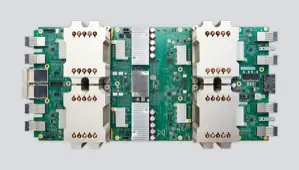
الصورة: Google · Copyright Google, all rights reserved · Google Cloud, preserved by the Internet Archive - 2020
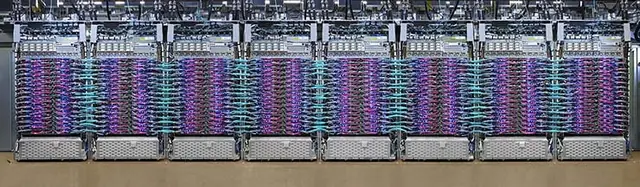
نموذج Vision Transformer (ViT)
يعامل أجزاء الصورة كرموز؛ فتنتشر نماذج Transformer إلى الرؤية الحاسوبية.
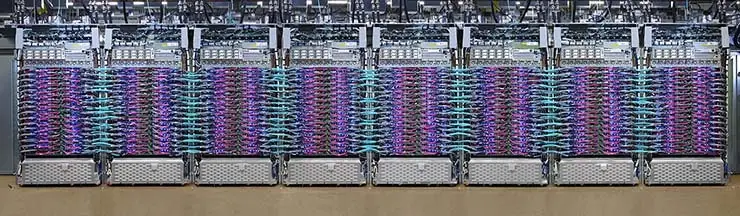
الصورة: Google · Copyright Google, all rights reserved · Data Center Frontier, credited to Google - 2021
مزيج الخبراء المتناثر (Switch Transformer)
توجيه كل رمز إلى واحدة من شبكات «خبراء» فرعية كثيرة يتيح نماذج بتريليون معامل بكلفة حوسبة ثابتة لكل رمز؛ ويستخدمه DeepSeek-V3 لاحقًا (2024) في النماذج الرائدة.
الصورة: Google LLC · Public domain · Wikimedia Commons